13 有限数据拟合与梯度法
能够把有限数据与模型族写成确定的优化问题,区分参数、输入和目标值;独立推导线性参数模型的梯度与正规方程;说明步长条件怎样控制下降与收敛;用参数误差、目标差和梯度范数共同判断计算结果。先修内容为第2章的数列极限、第10章的多元微分和第11章的凸性。矩阵仅用于有限线性方程组和二次型的紧凑表示。
13.1 从有限数表到目标函数
设给定\(m\)组数据\((x_i,y_i)\),其中\(x_i\in\mathbb{R}^d\)表示输入,\(y_i\in\mathbb{R}\)表示目标值。选择一个以\(\theta\in\mathbb{R}^p\)为参数的函数族\(f_\theta\)后,拟合问题是寻找同一个参数,使各个\(f_\theta(x_i)\)尽量接近\(y_i\)。这里的数据是已经给出的有限数表;平均符号只表示有限求和,不预设抽样分布,也不把尚未观测的输入混入当前目标。
模型族的选择先于参数的求解。例如,\(f_{a,b}(x)=ax+b\)允许所有直线,\(g_{a,b}(x)=ax^2+b\)允许关于纵轴对称的抛物线。两者都有两个参数,但可表示的函数不同。某种算法对其中一个目标求得精确最小值,并不能证明该模型族适合一切输入。
定义 13.1 (残差与平均平方损失). 在数据点\(i\)处的残差定义为\(r_i(\theta)=f_\theta(x_i)-y_i\)。平均平方损失为 \[\begin{equation} \label{eq:13-loss} J(\theta)=\frac{1}{2m}\sum_{i=1}^m r_i(\theta)^2. \end{equation}\] 因子\(1/2\)用于简化求导。若给定\(q_i>0\)且\(\sum_iq_i=1\),则加权损失为\(J_q(\theta)=\frac12\sum_iq_ir_i(\theta)^2\)。
残差保留偏差方向,而平方项只保留大小。权重的改变意味着不同数据点对目标的相对贡献发生变化,因而是问题定义的改变。将所有权重同时乘以正数不改变最小点,却会按相同比例改变梯度;若沿用原步长,迭代轨迹通常不同。
例 13.2 (常数模型的完整求解). 给定目标值\(1,2,6\),仅使用常数模型\(f_c(x)=c\)。此时输入不参与计算, \[J(c)=\frac16\bigl[(c-1)^2+(c-2)^2+(c-6)^2\bigr],\qquad J'(c)=c-3.\] 由\(J''(c)=1>0\),唯一最小点为\(c=3\),最小损失为\(7/3\)。直接配方给出 \[J(c)=\frac73+\frac12(c-3)^2.\] 残差为\(2,1,-3\),其和为零,但各残差并不都为零。若改用平均绝对误差,最小点为中位数\(2\)。因此”数据的最佳代表值”必须同时指定允许的模型和衡量误差的准则。
命题 13.3 (有限和的求导). 若每个\(\theta\mapsto f_\theta(x_i)\)在开集\(U\)上可微,则\(J\)在\(U\)上可微,且 \[\begin{equation} \label{eq:13-gradient-general} \nabla J(\theta)=\frac1m\sum_{i=1}^m r_i(\theta)\nabla_\theta f_\theta(x_i). \end{equation}\] 若这些函数二阶连续可微,则 \[\nabla^2J(\theta)=\frac1m\sum_{i=1}^m \left[\nabla f_\theta(x_i)\nabla f_\theta(x_i)^{\mathsf T} +r_i(\theta)\nabla^2f_\theta(x_i)\right].\]
证明. Proof. 对每一项使用复合函数求导法则,得到\(\nabla(r_i^2/2)=r_i\nabla r_i\)。输入\(x_i\)和目标\(y_i\)固定,故\(\nabla r_i=\nabla_\theta f_\theta(x_i)\)。有限求和可以逐项求导。再次求导时对\(r_i\nabla r_i\)使用乘积法则即得第二式。 ◻
Hessian的第一部分总是半正定,第二部分却未必如此。于是”平方损失对输出是凸函数”并不能推出”平方损失对任何模型的参数都是凸函数”。例如单点模型\(f_\theta=\theta^2\)、目标值为\(1\)时,\(J(\theta)=\frac12(\theta^2-1)^2\),在\(\theta=0\)处有\(J''(0)=-2\)。
拟合允许数据点处出现非零残差;插值要求所有残差同时为零;预测表示将已确定的函数用于新的输入。三者并非同义。插值首先是关于有限方程能否同时满足的代数问题,预测表现还取决于输入范围、模型结构和数据误差。当前数据上的损失值不能独立决定后一问题。
13.2 线性参数模型与正规方程
选定特征函数\(\phi_1,\ldots,\phi_p\),考虑 \[f_\theta(x)=\sum_{j=1}^p\theta_j\phi_j(x).\] 即使\(\phi_j\)包含\(x^2\)或\(\sin x\),该模型仍然对参数线性。令矩阵\(A\in\mathbb{R}^{m\times p}\)的第\(i,j\)个元素为\(\phi_j(x_i)\),\(y=(y_1,\ldots,y_m)^{\mathsf T}\),则 \[\begin{equation} \label{eq:13-ls} J(\theta)=\frac1{2m}\left\lVert A\theta-y\right\rVert^2,\quad \nabla J(\theta)=\frac1mA^{\mathsf T}(A\theta-y),\quad H=\nabla^2J=\frac1mA^{\mathsf T}A. \end{equation}\] 此处\(\left\lVert v\right\rVert^2=\sum_iv_i^2\)。计算\(A\theta\)得到\(m\)个输出,计算\(A^{\mathsf T}r\)得到\(p\)个参数方向上的变化率,矩阵形状与数学含义一致。
定理 13.4 (正规方程、存在性与唯一性). 对任意实矩阵\(A\)和向量\(y\),目标[eq:13-ls]至少有一个最小点。\(\theta_*\)为最小点当且仅当 \[\begin{equation} \label{eq:13-normal} A^{\mathsf T}(A\theta_*-y)=0. \end{equation}\] 若\(A\)的列线性无关,则最小点唯一;若列线性相关,则任一最小点加上任意\(\ker A\)中的向量仍为最小点。
证明. Proof. 令\(S=\{A\theta:\theta\in\mathbb{R}^p\}\)。它是有限维子空间。取其一组标准正交基\(e_1,\ldots,e_s\),令\(p=\sum_{j=1}^s\left\langle y,e_j\right\rangle e_j\);若\(S=\{0\}\),则令\(p=0\)。于是\(y-p\)与\(S\)正交。因\(p\in S\),存在\(\theta_*\)使\(A\theta_*=p\)。对任意\(h\), \[\begin{equation} \label{eq:13-expansion} J(\theta_*+h)=J(\theta_*)+ \frac1m\left\langle A\theta_*-y,Ah\right\rangle+\frac1{2m}\left\lVert Ah\right\rVert^2. \end{equation}\] 中间项为零,故\(\theta_*\)是最小点。对任意满足正规方程的参数,同一展开式也证明其最优性;反向结论由可微函数的内点极值必要条件得到。
若\(A\)的列线性无关,则\(h\ne0\)时\(Ah\ne0\),展开式表明其他参数的目标值严格更大。若\(Ah=0\),则\(A(\theta_*+h)=A\theta_*\),目标值不变。这同时给出了非唯一性的准确来源。 ◻
证明中的正交关系表示:最优残差与所有允许的输出改变量正交。它并不表示残差向量本身为零。若模型含有常数特征\(\phi_1\equiv1\),正规方程中相应的一行才给出\(\sum_ir_i=0\);省去截距后,此结论不再自动成立。
例 13.5 (三个点拟合一条直线). 给定\((-1,0),(0,2),(1,2)\),令\(f_{a,b}(x)=ax+b\)。有 \[A=\begin{pmatrix}-1&1\\0&1\\1&1\end{pmatrix},\qquad A^{\mathsf T}A=\begin{pmatrix}2&0\\0&3\end{pmatrix},\qquad A^{\mathsf T}y=\begin{pmatrix}2\\4\end{pmatrix}.\] 因此\(a_*=1,b_*=4/3\)。三个拟合值为\(1/3,4/3,7/3\),残差为\(1/3,-2/3,1/3\)。残差和为零,加权和\(\sum_ix_ir_i\)也为零,而最小损失为\(1/9\)。进一步展开得 \[\begin{equation} \label{eq:13-example-quadratic} J(a,b)=\frac19+\frac13(a-1)^2+\frac12(b-4/3)^2. \end{equation}\] 此式不仅给出最小点,还给出各参数方向的曲率,为后面的迭代分析提供了精确基准。
例 13.6 (输出唯一而参数不唯一). 将模型改为\(f_{a,b,c}(x)=ax+bx+c\),并仍使用上述三个点。输出只依赖\(s=a+b\)与\(c\)。所有满足\(a+b=1,c=4/3\)的参数均为最小点,例如\((1,0,4/3)\)与\((1/2,1/2,4/3)\)。它们在任意\(x\)上的函数值相同。于是参数不唯一有时仅是表示重复;若只在训练输入处特征相关,则不同最小点还可能在新输入处产生不同输出。
注记. 说明 13.7. 正规方程用于理论推导十分便利。对大型或尺度相差很大的问题,直接形成\(A^{\mathsf T}A\)可能放大数值困难。此处以可手算的小矩阵说明结构,不将矩阵求逆作为普遍的数值算法建议。方程组能够求解,也不要求先显式计算逆矩阵。
13.3 梯度迭代为什么下降
梯度法从初值\(\theta_0\)出发,按 \[\begin{equation} \label{eq:13-gd} \theta_{k+1}=\theta_k-\eta\nabla J(\theta_k) \end{equation}\] 更新,其中\(\eta>0\)称为步长或学习率。负梯度给出局部一阶下降方向;实际更新是有限距离的移动,因而必须控制一阶近似的余项。第5章的Taylor估计在这里转化为步长条件。
定理 13.8 (下降估计与梯度趋零). 设\(J:\mathbb{R}^p\to\mathbb{R}\)可微,其梯度满足 \(\left\lVert \nabla J(u)-\nabla J(v)\right\rVert\le L\left\lVert u-v\right\rVert\),其中\(L>0\)。则 \[\begin{equation} \label{eq:13-descent} J(\theta-\eta\nabla J(\theta)) \le J(\theta)-\eta\left(1-\frac{L\eta}{2}\right)\left\lVert \nabla J(\theta)\right\rVert^2. \end{equation}\] 若\(J\)有下界,且固定\(0<\eta<2/L\),则迭代[eq:13-gd]满足\(\left\lVert \nabla J(\theta_k)\right\rVert\to0\)。
证明. Proof. 对任意增量\(d\),沿线段使用微积分基本定理, \[J(\theta+d)-J(\theta)-\left\langle \nabla J(\theta),d\right\rangle =\int_0^1\left\langle \nabla J(\theta+td)-\nabla J(\theta),d\right\rangle\mathop{}\!\mathrm{d}t \le\frac L2\left\lVert d\right\rVert^2.\] 代入\(d=-\eta\nabla J(\theta)\)即得下降估计。记\(c=\eta(1-L\eta/2)>0\),将估计式从\(k=0\)加至\(N-1\),得 \[c\sum_{k=0}^{N-1}\left\lVert \nabla J(\theta_k)\right\rVert^2 \le J(\theta_0)-J(\theta_N) \le J(\theta_0)-\inf J.\] 左端是非负项级数的部分和且一致有界,故各项趋于零。 ◻
该定理证明了梯度范数趋于零,没有直接证明参数序列收敛,也没有直接证明其极限为全局最小点。要得到这些更强结论,必须继续使用目标的结构。其有限步版本同样有用: \[\min_{0\le k<N}\left\lVert \nabla J(\theta_k)\right\rVert^2 \le\frac{J(\theta_0)-\inf J}{cN}.\] 这是对前\(N\)步中至少一个梯度的估计,并非声称每一步的梯度都按此速度下降。
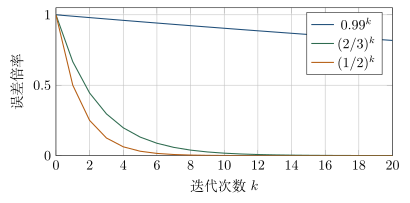
例 13.9 (把二维迭代拆成两个数列). 对[eq:13-example-quadratic]取\(\eta=1/2\),则 \[a_{k+1}-1=\frac23(a_k-1),\qquad b_{k+1}-\frac43=\frac12\left(b_k-\frac43\right).\] 由\((a_0,b_0)=(0,0)\)出发, \[a_k=1-(2/3)^k,\qquad b_k=\frac43\bigl[1-(1/2)^k\bigr].\] 前几步如表13.1。两个坐标的收敛速度不同,长期误差由较慢的\(a\)方向主导。已知最小损失\(1/9\)时,观察\(J_k-1/9\)比直接观察\(J_k\)更能看清后期变化。
| \(k\) | \(a_k\) | \(b_k\) | \(J_k-J_*\) |
|---|---|---|---|
| 0 | \(0\) | \(0\) | \(11/9\) |
| 1 | \(1/3\) | \(2/3\) | \(10/27\) |
| 2 | \(5/9\) | \(1\) | \(59/486\) |
| 3 | \(19/27\) | \(7/6\) | \(755/17496\) |
在\(J(t)=t^2/2\)上,迭代为\(t_{k+1}=(1-\eta)t_k\)。当\(0<\eta<2\)时收敛;\(\eta=2\)时非零初值在两点间振荡;\(\eta>2\)时绝对值发散。若只检查第一步的更新符号,三种情况都沿着负梯度开始,无法区分其长期行为。
13.4 二次目标的速率与参数尺度
对线性参数模型,Hessian\(H=A^{\mathsf T}A/m\)是常矩阵。于是梯度迭代不是无法分析的黑箱,而是一个线性递推。以下结论将第2章的等比数列推广到若干相互正交的方向。
定理 13.10 (正定二次目标的线性收敛). 设\(J(\theta)=J_*+\frac12(\theta-\theta_*)^{\mathsf T}H(\theta-\theta_*)\),其中\(H\)为实对称正定矩阵,其最小、最大特征值分别为\(\mu,L\)。若\(0<\eta<2/L\),则 \[\begin{equation} \label{eq:13-rate} \left\lVert \theta_k-\theta_*\right\rVert\le q^k\left\lVert \theta_0-\theta_*\right\rVert,\qquad q=\max_{\lambda\in[\mu,L]}\left\lvert 1-\eta\lambda\right\rvert<1. \end{equation}\] 同时有 \[\frac\mu2\left\lVert \theta-\theta_*\right\rVert^2 \le J(\theta)-J_*\le\frac L2\left\lVert \theta-\theta_*\right\rVert^2, \qquad \left\lVert \theta-\theta_*\right\rVert\le\frac1\mu\left\lVert \nabla J(\theta)\right\rVert.\]
证明. Proof. 令\(e_k=\theta_k-\theta_*\),则\(e_{k+1}=(I-\eta H)e_k\)。实对称矩阵有一组标准正交特征向量。在第\(j\)个特征方向上,误差分量乘以\(1-\eta\lambda_j\),其绝对值小于\(1\)。各方向平方求和得\(\left\lVert e_{k+1}\right\rVert\le q\left\lVert e_k\right\rVert\),递推得到[eq:13-rate]。其余不等式分别由 \(\mu\left\lVert e\right\rVert^2\le e^{\mathsf T}He\le L\left\lVert e\right\rVert^2\) 及\(\left\lVert He\right\rVert^2\ge\mu^2\left\lVert e\right\rVert^2\)得到。 ◻
在上述区间上,最大绝对值由端点取得。令\(1-\eta\mu=-(1-\eta L)\),得到使这一最坏方向收缩因子最小的固定步长 \[\eta_* =\frac2{L+\mu},\qquad q_* =\frac{L-\mu}{L+\mu}.\] 当条件数\(\kappa=L/\mu\)很大时,\(q_*=(\kappa-1)/(\kappa+1)\)接近\(1\)。这说明即便步长经过优化,固定步长的普通梯度法仍可能缓慢。该结论针对正定二次目标,不能原样当作所有神经网络训练的最优步长公式。
例 13.11 (单位改变引起的慢方向). 考虑\(Q(u,v)=\frac12(u-1)^2+50(v-1)^2\)。Hessian为\(\mathop{\mathrm{diag}}(1,100)\)。取\(\eta=0.01\),一步后\(v\)即达到\(1\),而\(u_k-1=0.99^k(u_0-1)\)。若\(u_0=0\),要使\(\left\lvert u_k-1\right\rvert\le0.01\),必须有\(k\ge459\)。令\(z=10(v-1)\),\(s=u-1\),则\(Q=(s^2+z^2)/2\),在新坐标用步长\(1\)只需一步到达最小点。坐标变换后的欧氏梯度对应原坐标中的不同更新规则,不能理解为仅把图的横纵轴标签改写了一遍。
对直线模型,令\(\bar x=m^{-1}\sum_ix_i\),使用\(z_i=x_i-\bar x\)可消去斜率与截距在Hessian中的交叉项。若再令\(s^2=m^{-1}\sum_i(x_i-\bar x)^2>0\),采用\(z_i=(x_i-\bar x)/s\),则\(\frac1m\sum_i z_i=0\)、\(\frac1m\sum_i z_i^2=1\),新参数的Hessian成为单位矩阵。若\(s=0\),标准化公式无意义,而所有输入相同正是斜率无法独立确定的情形。
13.5 有限计算、批量与停止判断
目标[eq:13-loss]中的每个数据点都参与梯度,称为全量梯度。若将数据分为不相交的非空组\(B_1,\ldots,B_s\),记各组平均梯度为 \[g_j(\theta)=\frac1{|B_j|}\sum_{i\in B_j}r_i(\theta)\nabla f_\theta(x_i),\] 则全量梯度为\(\sum_j(|B_j|/m)g_j(\theta)\)。这一恒等式要求所有组在同一个参数\(\theta\)上计算。如果每处理一组就更新参数,下一组的梯度取值点已经改变,不能再把一个循环说成一次全量更新。
例 13.12 (顺序更新留下的固定偏移). 常数模型拟合目标值\(0,2\),全量损失为 \(J(c)=\frac14[c^2+(c-2)^2]\),最小点为\(c_*=1\)。按顺序先处理\(0\)、再处理\(2\),每个点使用单点损失\((c-y)^2/2\)和步长\(\eta\)。一个循环得到 \[c'=(1-\eta)c,\qquad c''=(1-\eta)c'+2\eta=(1-\eta)^2c+2\eta.\] 若\(0<\eta<2\),循环端点收敛到\(2/(2-\eta)\),通常不等于\(1\)。取\(\eta=1/2\),端点趋于\(4/3\),中间点趋于\(2/3\)。固定步长的逐点更新因此产生两点循环。此结论来自确定性递推,无需引入随机抽样或概率收敛。
命题 13.13 (小梯度不总意味着小参数误差). 不存在与目标无关的常数\(C\),使所有正定二次函数都满足\(\left\lVert \theta-\theta_*\right\rVert\le C\left\lVert \nabla J(\theta)\right\rVert\)。
证明. Proof. 取\(J_\varepsilon(t)=\varepsilon(t-1)^2/2\),其中\(\varepsilon>0\)。在\(t=0\)处,参数误差为\(1\),梯度绝对值为\(\varepsilon\)。若这样的统一常数存在,则\(1\le C\varepsilon\)对任意\(\varepsilon>0\)成立,矛盾。前述误差界中的\(1/\mu\)因而不能省略。 ◻
实际停止规则可以并列记录目标相对变化、梯度范数及参数步长。对固定步长法,参数步长等于\(\eta\left\lVert \nabla J\right\rVert\);若步长极小,参数变化小并不能说明已接近驻点。相对变化还需避免分母为零,例如用\(\left\lvert J_{k+1}-J_k\right\rvert/\max\{1,\left\lvert J_k\right\rvert\}\)。这些是有限计算的判据,其含义应在具体问题中解释。
下面的程序只计算本章三点直线模型。数据、初值和步长均明确写出,所得每一步可以与闭式递推核对。输出保留目标、两个参数和梯度范数,便于发现仅观察损失时不易看出的异常。
from math import sqrt

data = [(-1.0, 0.0), (0.0, 2.0), (1.0, 2.0)]
a, b, eta = 0.0, 0.0, 0.5
for k in range(9):
    residual = [a*x + b-y for x, y in data]
    loss = sum(r*r for r in residual)/6.0
    ga = sum(x*r for (x, y), r in zip(data, residual))/3.0
    gb = sum(residual)/3.0
    print(k, a, b, loss, sqrt(ga*ga + gb*gb))
a, b = a-eta*ga, b-eta*gb同时赋值保证两个新参数使用同一旧状态的梯度。对含有交叉依赖的一般目标,若先更新\(a\),再用新\(a\)计算\(b\)的梯度,得到的通常是另一种迭代。本例两个参数方向恰好解耦,\(b\)方向梯度不依赖\(a\),但仍采用同时更新形式以保持算法定义一致。程序正确性首先是所执行运算与所定义算法的一致性,随后才是输出数值是否合理。
13.6 本章回顾与分层习题
本章的逻辑依次为:有限数据确定目标,微分给出梯度,二次结构给出最小点,余项估计限制步长,递推结构给出收敛速度。模型误差、优化误差和计算误差属于不同层面:增大迭代次数可以减少特定条件下的优化误差,却不改变模型族本身。
基础题
用常数模型拟合\(-1,1,4,8\),求最小参数、残差和最小平均平方损失。
对数据\((-1,1),(0,0),(1,1)\),分别求直线模型\(ax+b\)与偶二次模型\(ax^2+b\)的最优参数,并比较最小损失。
写出模型\(f_{a,b}(x)=a\sin x+b\)在有限数据上的梯度与Hessian。指出最小点唯一的充要条件。
对\(J(t)=2(t-3)^2\),求固定步长梯度法收敛的步长区间,并求能够一步到达最小点的步长。
对[eq:13-example-quadratic]取\(\eta=1\)、\((a_0,b_0)=(0,0)\),求\(a_k,b_k\)与\(J_k-J_*\)。
将所有平方损失乘以\(10\),怎样调整固定步长,才能保持原来的参数轨迹?
推理题
证明:若线性参数模型含常数特征,则任一最优残差的算术平均为零。给出不含常数特征时结论失败的例子。
设\(H\)为半正定矩阵且二次目标有最小点。证明当\(0<\eta<2/L\)时,梯度法在正特征值方向上收敛,而在\(\ker H\)方向上的初始分量保持不变。说明最小点不唯一时初值的作用。约定\(H\ne0\)且\(L\)为最大特征值。
证明,对于正定二次目标,\(J(\theta)-J_*\le\left\lVert \nabla J(\theta)\right\rVert^2/(2\mu)\)。比较它与参数误差界。
将直线拟合输入中心化。证明交叉项消失,并写出原参数\((a,b)\)与中心化参数\((\alpha,\beta)\)的转换关系。
拓展题
将顺序更新例中的两个目标值改成\(p,q\)。求每个循环端点的极限,并分析先后次序互换的影响。
对\(J(t)=\frac12(t^2-1)^2\),求全部驻点及其类型。解释从\(t_0=0\)出发的梯度法为何永远不动,并计算从小正数出发时第一步向哪个方向移动。
13.7 本章选题解答
四个目标的平均值为\(3\),残差为\(4,2,-1,-5\),平方和为\(46\),故最小损失为\(46/8=23/4\)。由恒等式\(\sum_i(c-y_i)^2=4(c-3)^2+46\)直接验证最优性。
对直线模型,\(\sum x_i=0\)、\(\sum x_iy_i=0\),得\(a=0,b=2/3\)。残差为\(-1/3,2/3,-1/3\),最小损失为\(1/9\)。偶二次模型取\(a=1,b=0\)即满足三个点,损失为零。两模型的参数个数相同,表达能力仍不同。
记\(s_i=\sin x_i\),\(r_i=as_i+b-y_i\),则\(\nabla J=m^{-1}(\sum_i s_ir_i,\sum_i r_i)^{\mathsf T}\), \[H=\frac1m\begin{pmatrix}\sum_i s_i^2&\sum_i s_i\\\sum_i s_i&m\end{pmatrix}.\] 其行列式为\(m^{-1}\sum_i(s_i-\bar s)^2\),故唯一性等价于\(s_i\)不全相等。输入\(x_i\)不同并不足以保证这一条件,例如\(x_i=0,\pi\)时正弦值相同。
递推为\(t_{k+1}-3=(1-4\eta)(t_k-3)\)。对所有初值收敛当且仅当\(0<\eta<1/2\);取\(\eta=1/4\)时一次更新即到\(3\)。初值已在最小点时,任何步长都保持该点,这一特例不改变面向所有初值的步长区间。
有\(a_k=1-(1/3)^k\)。\(b_0=0\),而\(k\ge1\)时\(b_k=4/3\)。故\(J_0-J_*=11/9\),\(k\ge1\)时\(J_k-J_*=(1/3)\,9^{-k}\)。
新梯度为原梯度的\(10\)倍,使用新步长\(\eta/10\)即可保持每次更新相同,初值相同则整条轨迹相同。
常数特征对应设计矩阵的一列全为\(1\)。正规方程相应分量为\(\sum_i r_i=0\)。反例可取单点\((x,y)=(0,1)\)及无截距模型\(f_a(x)=ax\);任何参数都是最小点,而残差始终为\(-1\)。
取\(H\)的标准正交特征基。正特征方向的误差按\(1-\eta\lambda_j\)递推并趋于零;零特征方向的倍率为\(1\)。因梯度总与\(\ker H\)正交,迭代不会改变该方向的初值分量。极限是最小点集合中保留这些分量的唯一一点。
在特征基中记误差分量为\(e_j\)。则\(J-J_*=\frac12\sum_j\lambda_je_j^2\),而\(\left\lVert \nabla J\right\rVert^2=\sum_j\lambda_j^2e_j^2\ge\mu\sum_j\lambda_je_j^2\)。整理即得结论;它估计目标差,不是参数距离,两者量纲也不同。
令\(z_i=x_i-\bar x\)。有\(\sum_iz_i=0\),故\(H\)中交叉项为零。恒等式\(ax+b=\alpha(x-\bar x)+\beta\)给出\(\alpha=a\)、\(\beta=b+a\bar x\),反向为\(a=\alpha\)、\(b=\beta-\alpha\bar x\)。
一个循环为\(c''=(1-\eta)^2c+\eta(1-\eta)p+\eta q\),故\(0<\eta<2\)时端点极限为\([(1-\eta)p+q]/(2-\eta)\)。次序互换后为\([(1-\eta)q+p]/(2-\eta)\),两者相差\(\eta(q-p)/(2-\eta)\)。只有特定情形下才等于平均值。
\(J'(t)=2t(t^2-1)\),驻点为\(-1,0,1\)。\(J''(t)=6t^2-2\),故\(\pm1\)为严格极小点,\(0\)为严格极大点。零初值梯度为零,更新保持不变;当\(0<t_0<1\)时梯度为负,所以任意正步长的第一步向右移动,但过大的步长仍可能越过稳定区域。